
莱卡云美国VPS真机实测:19.99元/月2核2G,三网优化回程157ms
这篇文章和站内其他测评不太一样。过去几年我们写过的 VPS 评测,性能数据大多来自商家公开资料或第三方测评的转述——UnixBench 这个词在站内出现过三十多次,但没有一次是我们自己跑出来的。原因很直接:我们没有对应商家的真机。
这次不一样。我们拿到了一台真实在售、已连续运行 40 天的莱卡云美国实例(产品名「美国特惠款」),在上面完整跑了一遍 CPU、内存、磁盘、UnixBench、带宽和国内双源延迟测试。下面所有数字都出自这台机器,没有一个是从别处抄来的。
先说结论:这台 19.99 元/月的美国洛杉矶机器,回程是三网优化线路(电信 CN2、联通 AS9929、移动 CMI),国内访问延迟低到 157 毫秒且几乎不抖动。它的短板也很明确——4K 随机读写只有 2080 IOPS,因为套餐选的是「普通 IO」硬盘。下面逐项拆开看。
一、测试机与套餐:19.99 元/月的「美国特惠款」到底是什么配置
先把被测对象说清楚,否则后面的数据没有意义。这台机器来自莱卡云,控制台里的产品名是「美国特惠款」,机房在美国洛杉矶,操作系统 Debian 12,实付价格 19.99 元每月,月流量包 500G。截至测试时,实例已连续运行 40 天,流量消耗 16.4G,还剩 483.6G。
需要特别说明的是:这台机器不是空载的。上面跑着三个生产站点、宝塔面板和若干容器进程。所以下面所有性能数据,都是「带负载的真实业务环境」下的结果,而不是刚开通、干干净净的新机器跑出来的漂亮分数。这一点会影响磁盘和 CPU 的绝对值,我们在每一项里都会说明。
另外,出于对业务安全的基本考虑,本文对测试机的公网 IP 末位与实例 ID 做了隐去处理。这不影响任何测试结论——所有数据都可在你自己的莱卡云美国实例上复现。
| 项目 | 实测值 |
|---|---|
| 产品 | 莱卡云「美国特惠款」 |
| 机房 | 美国 · 洛杉矶 |
| IP / 归属 | 154.201.77.x(末位隐去)· AS402506 Zenixcloud Inc |
| CPU | Intel Xeon Gold 6133 @ 2.50GHz × 2 vCPU |
| 内存 | 1966 MB(可用 1054 MB) |
| 硬盘 | 50 GB(xfs,已用 32%),普通 IO |
| 虚拟化 | KVM 全虚拟化 |
| 系统 | Debian GNU/Linux 12 (bookworm),内核 6.1 |
| 月流量 | 500 G(已用 16.4 G) |
| 价格 | 19.99 元 / 月 |
顺带解释一个容易被误解的点:IP 归属查询显示这台机器的 AS 是 Zenixcloud 而不是莱卡云自有 AS。判断一台云服务器属于哪家商家,看的是控制台和账单,而不是 AS 归属——上游 IP 段的持有方与售卖方不一致,在云服务行业里是常见情况。
二、CPU 与内存:Xeon Gold 6133 的真实水平
这颗 CPU 是 Intel Xeon Gold 6133,2017 年 Skylake-SP 平台的产物,20 核 40 线程、2.5GHz 基频、3.0GHz 加速频率。它不是新东西,但在这个价位上属于常见配置。
用 sysbench 1.0.20 跑 --cpu-max-prime=20000,单核得 341.27 events/s,双核 674.33 events/s。两个数字一除,多核倍率是 1.98——接近理想的 2.0,说明两个 vCPU 之间没有明显的资源争抢。
为了确认这个分数没有被测试环境干扰,我们特意做了对照:第一轮用了 nice -n 19(最低优先级,避免抢生产业务的 CPU),拿到 341.27;随后不带 nice 连跑三轮,得到 343.38、340.98、339.41。两组数据几乎完全一致,波动不到 1.2%。这说明机器本身足够空闲,低优先级并没有扭曲结果,也说明 341 events/s 就是这台机器的真实水平。
| 测试项 | 参数 | 结果 |
|---|---|---|
| CPU 单核 | sysbench cpu, prime=20000, 30s | 341.27 events/s |
| CPU 双核 | sysbench cpu, prime=20000, 30s | 674.33 events/s |
| 多核倍率 | — | 1.98 |
| 内存吞吐 | sysbench memory, 1M block, 10G total | 14756.91 MiB/s |
怎么理解 341 events/s?这个成绩在入门到中端之间。建站、跑轻量应用、做中转转发完全够用;但如果你的业务是视频转码、大规模并发计算这类吃满 CPU 的场景,两颗 2017 年的核心会很快成为瓶颈。内存带宽 14756 MiB/s 属于 KVM 虚拟机的常规水平,没有异常。
三、磁盘 IO:普通 IO 档位的真实边界
磁盘是这台机器最需要留意的地方。用 fio 3.33 在 direct=1 直写模式下测(绕过系统缓存,测的是真实盘),结果如下。
1M 大块顺序读写都稳定在 210 MiB/s,IOPS 都是 209。读写数值一模一样,这不是巧合——它说明瓶颈在虚拟化层的 IO 带宽限速上,而不是物理盘的读写能力。换句话说,给你多少带宽是平台定好的,不是盘跑不动。
真正要看的是 4K 小块:随机读 2083 IOPS,随机写 2081 IOPS,带宽都只有 8.5 MB/s。这个数字在共享存储里属于中低水平。原因不难找——这台机器的套餐选用的是「普通 IO」硬盘类型,莱卡云产品页上还提供「高 IO」可选档位。
我们用 dd 做了交叉验证:写 512MB 得 379 MB/s,读 512MB 得 507 MB/s。这两个数字比 fio 高不少,是因为 dd 的写入量小(只有 512MB),部分受益于存储侧的缓存加速。对外引用时应当以 fio 的 direct IO 数据为准,dd 的数字参考价值有限。
| 测试项 | 块大小 | 队列深度 | 带宽 | IOPS |
|---|---|---|---|---|
| 顺序写 | 1 MiB | 16 | 210 MiB/s | 209 |
| 顺序读 | 1 MiB | 16 | 210 MiB/s | 209 |
| 随机读 | 4 KiB | 64 | 8.5 MB/s | 2083 |
| 随机写 | 4 KiB | 64 | 8.5 MB/s | 2081 |
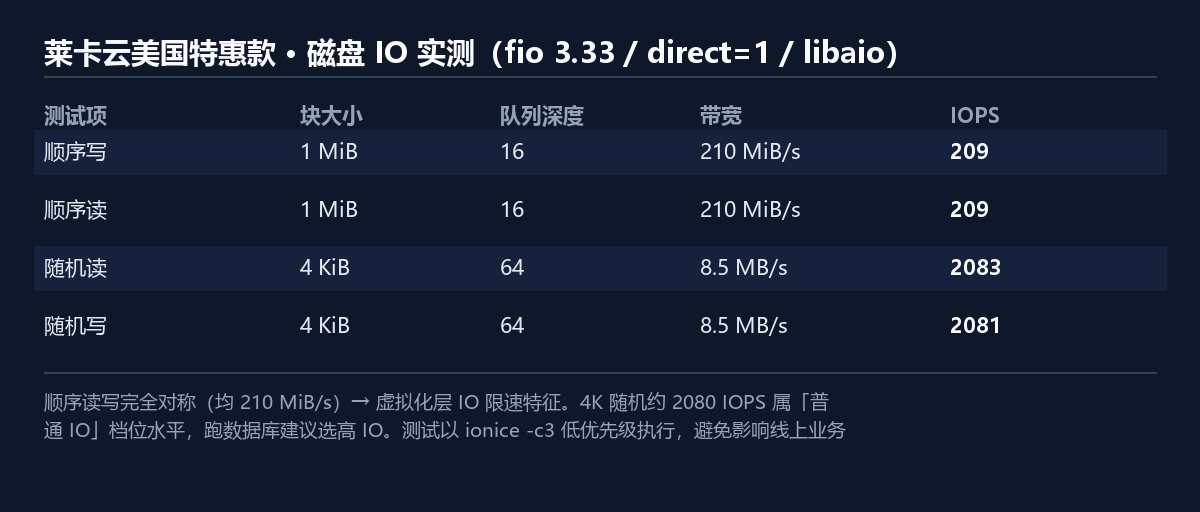
实际影响是什么?如果你只是放静态网站、跑 WordPress、做文件下载站,顺序读写才是主要负载,210 MiB/s 完全够用。但如果你打算在上面跑 MySQL 并承担写密集的业务,2080 IOPS 会明显吃紧——这也是为什么我们的建议是:要跑数据库,下单时就选「高 IO」档位。想横向对比其他美国 VPS 的磁盘配置,可以翻一下主机商资料库。
四、UnixBench 跑分与第三方数据对比
UnixBench 是 VPS 圈最通用的综合跑分,我们用的是 byte-unixbench 5.1.3——和主流第三方测评同一个版本,数字可以直接比。
单核 537.4,双核 968.4,多核倍率 1.80。
这个成绩比第三方测评低,我们不打算回避。第三方博客 Zeruns's Blog 在 2025 年 4 月测过莱卡云美国 ISP 家宽机型,UnixBench 单核 838、双核 1570.8。差距有三层原因,都得说清楚:
第一,CPU 型号不同。第三方测的是 Xeon Gold 6138,加速频率 3.7GHz;我们这台是 6133,加速频率只有 3.0GHz。单核性能对加速频率高度敏感,这是最主要的差距来源。第二,产品线不同——第三方测的是「美国 ISP 家宽(住宅 IP)」产品,我们测的是「美国特惠款」普通洛杉矶节点,两者不是同一个商品。第三,也是最实在的一点:我们的测试机已经连续运行 40 天,上面跑着三个生产站点和容器,不是刚开通的空机器。
| 项目 | 本机实测(6133,2026-09) | 第三方实测(6138,2025-04) |
|---|---|---|
| UnixBench 单核 | 537.4 | 838 |
| UnixBench 双核 | 968.4 | 1570.8 |
| 多核倍率 | 1.80 | 1.87 |
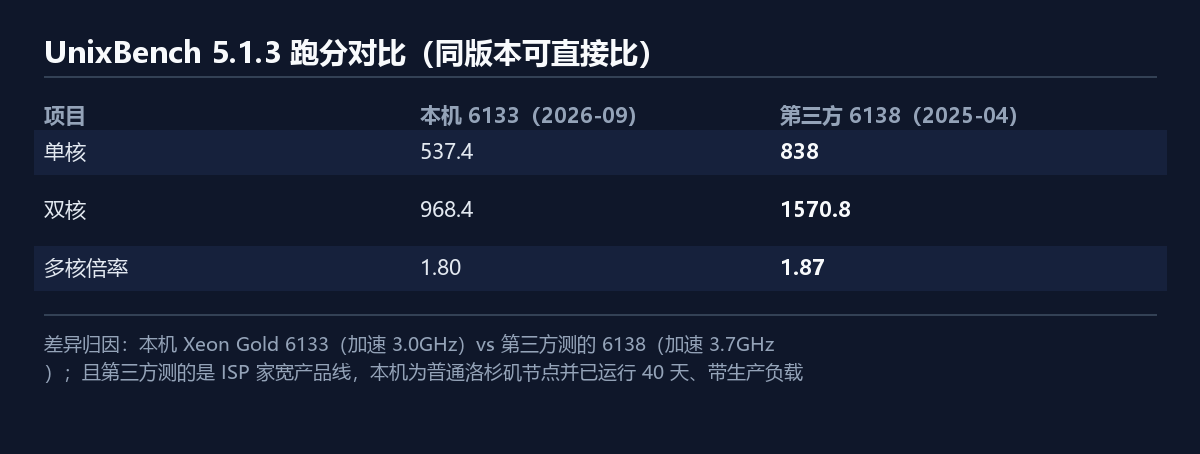
把这三条摆出来,读者可以自己判断该采信哪一组。我们倾向于这样理解:如果你买到的是 6138 机型,性能会明显好于本文数据;如果你买的是「美国特惠款」这个档位,那 537 分就是更接近实际的预期。
五、国内访问延迟:双源实测,广东电信 157ms
延迟是国内用户最关心的指标,也是最容易被单点数据误导的指标。我们在国内准备了两台探测源——一台是广东电信(AS4816,单线),一台是阿里云北京(AS37963,BGP 多线)——各自向这台机器发 20 个 ICMP 包。
广东电信的结果是平均 157.0 ms,20 包全收,零丢包,抖动(mdev)只有 1.6 ms。阿里云北京是 168.4 ms,同样零丢包,而 mdev 低到 0.392 ms——这个抖动水平非常罕见,说明链路全程几乎没有任何拥塞或绕行。
两地相差 11.4 ms,符合「广东离美西更近」的地理规律。这里要强调一个方法论问题:两个源的数字不能混着说。广东电信的 157.0 ms 是「广东电信 → 洛杉矶」的口径,阿里云北京的 168.4 ms 是「北京 → 洛杉矶」的口径,它们衡量的是不同路径。
把 157.0 ms 放进我们此前做过的美西横评里对比,它的位置是这样的:
| 商家 | 机房 | 丢包 | 平均延迟 |
|---|---|---|---|
| 莱卡云 | 洛杉矶(美国特惠款) | 0% | 157.0 ms |
| RackNerd | 圣何塞 | 0% | 165.2 ms |
| 搬瓦工 | 洛杉矶 DC6 CN2 GIA-E | 0% | 165.5 ms |
| HostDare | 洛杉矶 | 0% | 165.7 ms |
| Vultr | 圣何塞(硅谷) | 15% | 171.1 ms |
| RackNerd | 洛杉矶 DC-03 | 30% | 177.1 ms |
| RackNerd | 西雅图 | 15% | 192.6 ms |
| Vultr | 西雅图 | 0% | 198.5 ms |
| Vultr | 洛杉矶 | 10% | 256.5 ms |
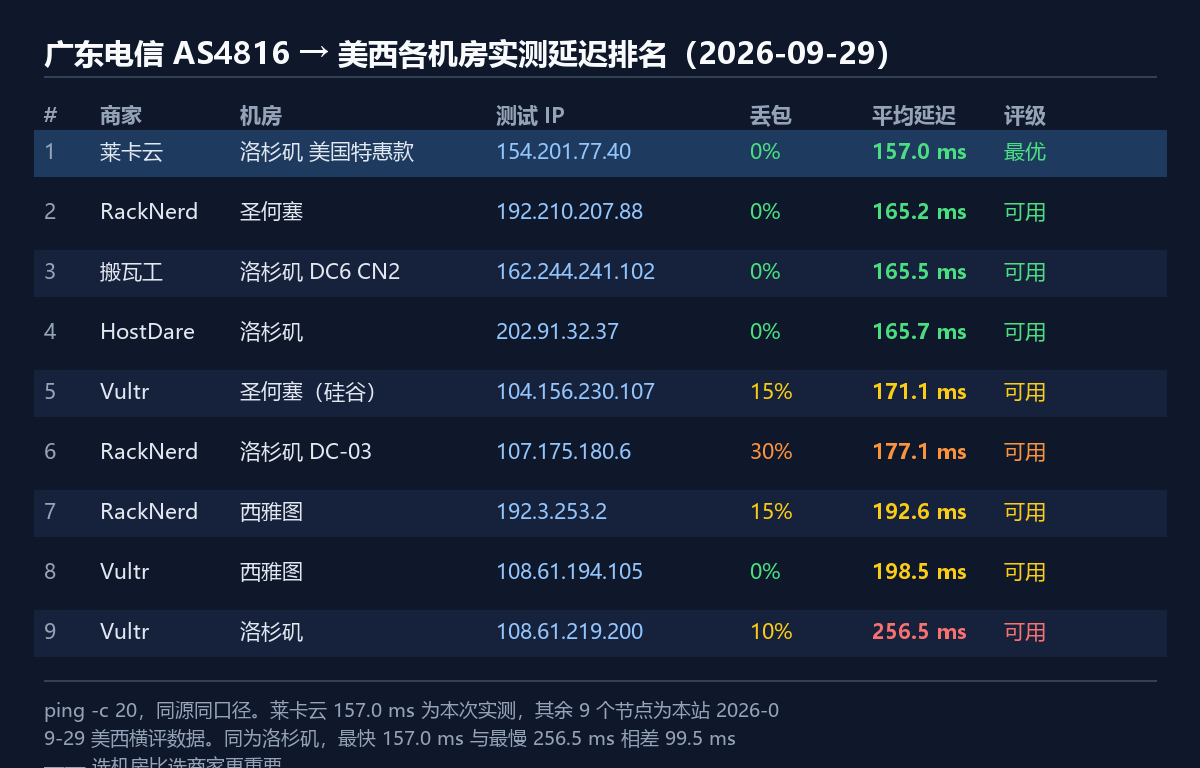
同源同口径下,莱卡云这台 157.0 ms 是九台里最快的,比搬瓦工洛杉矶 DC6 还低 8.5 ms。更值得注意的是同为洛杉矶机房,最快的 157.0 ms 和最慢的 256.5 ms 差了 99.5 ms——选机房和线路,比选商家名字重要得多。
表格里只有九台,是因为该次横评还测了另外两个测试 IP(RackNerd 洛杉矶 DC-02、DMIT 洛杉矶 LAX),它们不响应 ICMP、20 包全丢,未取得延迟数据,故不列入排名。本文不做任何估算,也不拿第三方数字顶替。
另外需要说明样本量的限制:以上每组数据来自 20 个 ICMP 包,属于短时采样。它能反映当下的线路质量,但不能替代长期稳定性观测。晚高峰时段的结果可能不同,建议有条件的话在两个时段各测一次。
六、回程路由:三网优化才是核心卖点
延迟低不是运气,是线路决定的。我们从实例侧向国内三网目标各跑了一次 traceroute,结果很干净。
电信方向,从机房出口 218.30.48.85 出去之后,第 10 跳就进入 59.43.189.33——这是中国电信 CN2 的地址段。上海、北京、广州三个方向全部走 CN2,而不是普通的 163 骨干(202.97.x.x 只在最末端出现)。
联通方向走的是 218.105.2.93,属于联通 AS9929,也就是联通国际精品网。移动方向走 223.120.197.5,是移动 CMI 国际线路。
| 运营商 | 关键跳 | 线路判定 |
|---|---|---|
| 电信(上海) | 218.30.48.85 → 59.43.189.33 → 59.43.38.193 → 101.95.88.34 | CN2 |
| 电信(北京) | 218.30.48.85 → 59.43.246.237 → 59.43.39.189 → 59.43.46.85 | CN2 |
| 电信(广州) | 218.30.48.85 → 59.43.246.177 → 59.43.181.13 → 202.97.43.81 | CN2 |
| 联通(北京) | 162.219.85.173 → 218.105.2.93 → 218.105.131.101 → 210.78.30.166 | AS9929 精品网 |
| 移动(北京) | 223.120.201.48 → 223.120.197.5 → 221.183.92.121 | CMI |
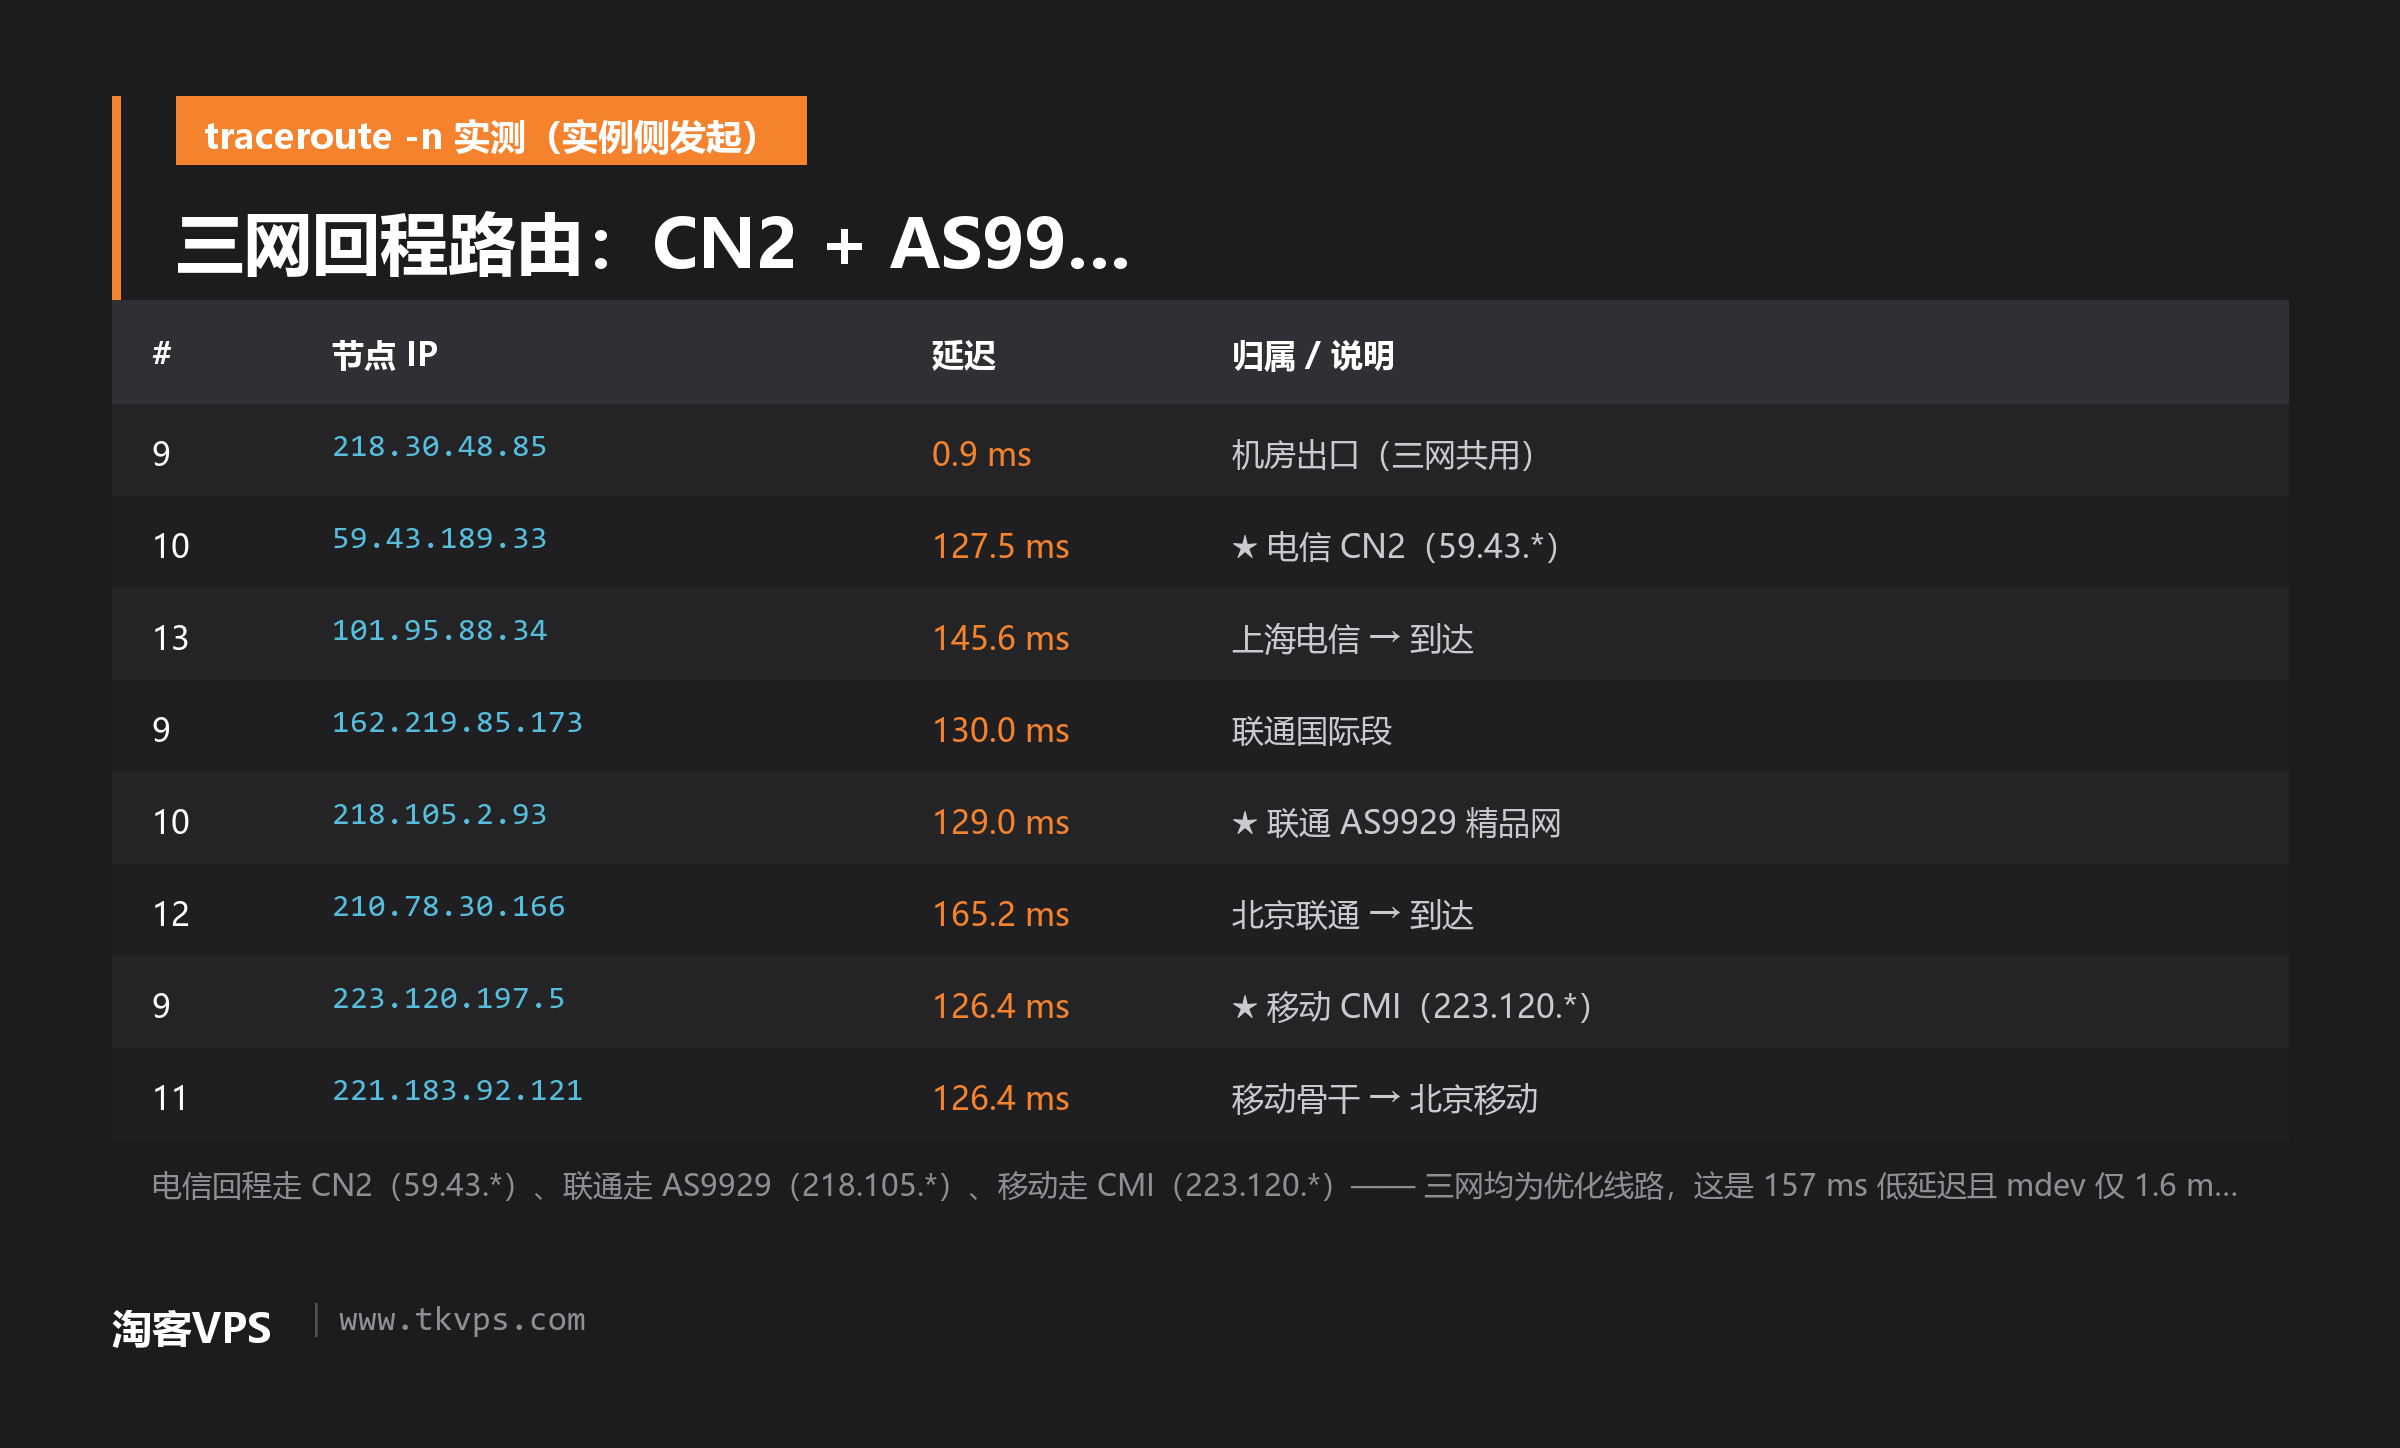
电信走 CN2、联通走 AS9929、移动走 CMI——三个方向用的都是各自运营商的优化承载线路,这在 20 元档的美国 VPS 里不常见。作为对照,我们之前测过的 10 个美西节点里,只有搬瓦工洛杉矶 DC6 出现了 CN2,其余大多走普通骨干或 Telia 国际段。莱卡云不仅同样有 CN2,延迟还更低。
这就解释了为什么它能做到 157 ms 且 mdev 只有 1.6 ms——路径短、线路好、不绕行,抖动自然小。对需要稳定国内访问的建站和中转场景来说,这个组合比单纯堆 CPU 核数更值钱。
需要坦白一处不足:去程路由我们没能拿到。两台国内探测源都没有安装 traceroute,而 tracepath 在第一跳内网网关之后就再无响应。回程数据(对访问体验影响更大的一方)是完整的,去程留白。
七、带宽实测:50Mbps,与官方标称一致
带宽这块我们做了两轮测试,因为第一轮的直觉判断差点出错。
单线程 curl 从 Cachefly 和 Linode 美西节点下载 100MB 文件,速度分别是 5.96 MB/s 和 5.88 MB/s,换算过来约 47 Mbps。这里有个常见的误判:单线程下载慢,很多时候是长肥管道(TCP 窗口)导致的,并不是带宽上限。所以我们又跑了 4 线程并发下载——结果每线程 1.50 MB/s,四个加起来 5.97 MB/s,和单线程完全一样。
这就排除了单线程瓶颈的可能,确认是端口硬限速。speedtest-cli 的结论一致:下载 46.87 Mbit/s,上传 49.25 Mbit/s,上下行对等。
| 测试方式 | 结果 |
|---|---|
| speedtest-cli 下载 | 46.87 Mbit/s |
| speedtest-cli 上传 | 49.25 Mbit/s |
| curl 单线程(Cachefly 100MB) | 5.96 MB/s ≈ 47.7 Mbps |
| curl 单线程(Linode 美西 100MB) | 5.88 MB/s ≈ 47.0 Mbps |
| curl 4 线程(Cachefly) | 每线程 1.50 MB/s,总和 5.97 MB/s |
对照官方产品页:「美国特惠款」标称带宽就是 50 Mbps。实测 46.87 / 49.25 Mbps,达标率约 94% 到 99%,属于正常链路损耗范围,没有虚标。
这里要提醒一句,莱卡云另有一条「美国双 ISP(住宅 IP)」产品线,标称带宽是 100 到 200 Mbps。它和本文测试的「美国特惠款」不是同一个档位,选购时别把两者的参数混在一起看。
八、这台机器适合谁,不适合谁
把上面七项数据拼起来,这台莱卡云美国VPS的画像其实很清晰。
它最值钱的地方是线路。电信 CN2、联通 9929、移动 CMI 三网优化回程,国内双源实测 157.0 和 168.4 毫秒、零丢包、抖动极小——这套组合在 20 元档里属于少见。如果你的业务是面向国内用户的外贸站、企业官网、轻量应用,或者需要一个稳定的中转节点,那么线路质量带来的体验提升,会远远盖过 CPU 只有两颗老核心这件事。
它的短板同样清楚。4K 随机读写 2080 IOPS 是共享存储「普通 IO」档位的结果,跑 MySQL 这类写密集服务会吃力,下单时选「高 IO」能缓解,但别指望它变成独服级别的盘。50 Mbps 带宽对中小流量站点够用,做视频分发或大文件下载站就明显偏紧。CPU 是 2017 年的 Skylake-SP,单核 UnixBench 537 分,算力型业务不要考虑。
一句话总结:这是一台「线路优先、算力够用」的机器。它把钱花在了国内访问体验上,而不是堆硬件参数。认这个取舍的人会觉得 19.99 元花得很值;需要算力和高 IO 的人则应该去看别的档位。
如果你还想横向对比美西其他机房的线路差异,可以看我们之前做的美国 VPS 机房横评,那篇把十个节点的延迟、丢包和路由放在同一口径下做了排名。选购前也可以先翻一下最新优惠码汇总,以及主机商资料库里莱卡云的其他机房条目。
九、测试方法与诚实声明
把方法和限制一次讲清楚,方便你判断这些数字的可信度,也方便别人复现。
| 项目 | 说明 |
|---|---|
| CPU | sysbench 1.0.20,--cpu-max-prime=20000 --time=30,nice -n 19 |
| 内存 | sysbench memory,1M block,10G total |
| 磁盘 | fio 3.33,direct=1 --ioengine=libaio,ionice -c3;另用 dd 512MB 交叉验证 |
| UnixBench | byte-unixbench v5.1.3,-c 1 / -c 2,-i 1 |
| 带宽 | speedtest-cli 2.1.3 + curl 单线程/4 线程交叉验证 |
| 延迟 | 广东电信 AS4816、阿里云北京 AS37963 双源,各 20 包 |
| 路由 | 实例侧 traceroute -n 至国内三网目标 |
| 测试日期 | 2026-09-29 |
三点必须声明的限制:
第一,测试机不是空载的。它已连续运行 40 天,跑着三个生产站点和容器进程。磁盘和 CPU 的绝对值因此会偏低一些。我们全程用 nice -n 19 和 ionice -c3 低优先级执行,尽量不影响线上业务;同时做了对照测试,验证低优先级没有扭曲 CPU 数据。
第二,去程路由缺失。原因已在第六节说明,不再重复。
第三,这是单台实例的数据。云服务的性能会随宿主机负载、批次硬件而变化,一次测试不能代表该产品线的全部水平。第三方测评的 6138 机型数据明显更高,就是一个例子。
我们不接受任何形式的赞助测试,本文数据全部出自我们自己跑的机器,原始输出保留在本地,可随时复核。如果你在别的莱卡云实例上测出了差异较大的结果,欢迎在评论区贴出来——同型号不同批次的数据差异,本身就是有价值的参考。