VPS 延迟怎么测才准:换探测源差 99ms,加包数只差 1ms
同一台洛杉矶机器,2026-11-01 上午 09:10,广东电信源 ping 20 包的平均值 255.652 ms,北京阿里云源同一分钟 156.370 ms,差 99.282 ms。两个数都是真的。
VPS 延迟怎么测才准,取决于四个变量:从哪儿测、用什么协议测、测了多少包、什么时段测。四个条件不写全,数字就没法互相比。
结论:同一台机器,两个源差 99ms
把三个变量摆在一起,VPS 延迟的量级差得很远。
| 变量 | 本次实测取值 | 带来的差 |
|---|---|---|
| 探测源 | 广东电信 255.652 / 北京阿里云 156.370 | 99.282 ms |
| 协议 | Vultr 官网 ping 229.000 / TCP 建连 0.435 s | 单位不同,不能直接相减 |
| 样本量 | 同一目标 -c 1 到 -c 100 | 1.393 ms |
| 时段 | 本次仅 09:10 单点采样 | 未测量,需自行补测 |
四行里第一行最大,第三行最小,VPS 延迟的误差结构就按这个顺序排。时段那一行没有数字,晚高峰这次没采,只能自己补。
开头那张表里的 255.652 / 156.370,是这一轮 7 台主机连着测下来的一次 20 包;变量二那组包数实验里的 -c 20,是另一组 3 次重复的均值 254.757 / 156.919。同一目标、同一包数、同一上午,两组数不是同一批包,差值都落在要量的毫秒级噪声里,不要互相代入。
很多人把 VPS 延迟怎么测理解成多测几包就准了。站外教程普遍写至少 ping 100 包,这个建议不错,但它解决的是另一个问题。本次同一目标、同一时段、同一台机器,-c 5 的均值 255.820 ms,-c 100 是 254.940 ms,包数从 5 加到 100,均值挪了不到一毫秒。
真正让 VPS 延迟数字对不上的,是探测源。同一目标、同一参数 -c 20,广东 254.757 ms、北京 156.919 ms,差 97.838 ms。包数从头到尾换一遍,广东自己的均值最大只动 1.393 ms,北京 0.667 ms,分别是那 97.838 ms 的 1.4% 和 0.7%。
看懂一个已经摆出来的数字是另一回事。min/avg/max/mdev/丢包 各自代表什么,讲指标含义的那篇说得更细;机器到手后要不要整台过一遍,验货流程是另一条线。这里只回答一件事:数字是怎么来的,误差有多大。
变量一:从哪测,VPS 延迟差在出口不在机房
这 7 个 Vultr 官方 ping 主机 2026-10-20 已经测过一轮,33 台 Vultr 主机的双源总表里有完整名单;今天是同一批主机的重跑,只取 7 台看误差。
2026-11-01 这一轮,每个目标每个源 20 包,超时 2 秒。
| 机房 | 官方主机名 | 广东 avg(ms) | 广东丢包 | 北京 avg(ms) | 北京丢包 | 广东减北京(ms) |
|---|---|---|---|---|---|---|
| 东京 | hnd-jp-ping.vultr.com |
231.200 | 0.0% | 110.593 | 20.0% | 120.607 |
| 首尔 | sel-kor-ping.vultr.com |
195.286 | 0.0% | 188.018 | 0.0% | 7.268 |
| 洛杉矶 | lax-ca-us-ping.vultr.com |
255.652 | 0.0% | 156.370 | 0.0% | 99.282 |
| 硅谷 | sjo-ca-us-ping.vultr.com |
158.476 | 0.0% | 155.942 | 0.0% | 2.534 |
| 法兰克福 | fra-de-ping.vultr.com |
194.501 | 0.0% | 233.311 | 0.0% | -38.810 |
| 阿姆斯特丹 | ams-nl-ping.vultr.com |
241.248 | 0.0% | 261.193 | 0.0% | -19.945 |
| 悉尼 | syd-au-ping.vultr.com |
382.624 | 0.0% | 228.095 | 0.0% | 154.529 |
两个源不是同一种东西。广东那台是电信单线,出口固定在 AS4816;北京那台是阿里云的多线 BGP,出口走哪条由路由表当刻决定。这两个数字之间的差,一半来自机房位置,一半来自两个源出海路径不同。
广东这边最快硅谷 158.476 ms,最慢悉尼 382.624 ms,极差 224.148 ms。北京这边最快东京 110.593 ms,最慢阿姆斯特丹 261.193 ms,极差 150.600 ms。同一批目标,换个源,VPS 延迟的快慢顺序就变了。
北京源更快的机房有 5 个,悉尼、东京、洛杉矶、首尔、硅谷。广东源更快的有 2 个,法兰克福和阿姆斯特丹。最后那一列是广东减北京,负号表示北京源更慢,不是算错。
东京那一行要连着丢包一起看。北京源 110.593 ms 是 7 个里最低的,但同一轮它的丢包是 20.0%,广东源是 0.0%。只看平均值,东京是北京方向的最优解;把丢包列摆上,这个结论就站不住。
反过来,硅谷两源 158.476 和 155.942,只差 2.534 ms。所以两个源之间没有固定倍数:悉尼差 154.529 ms,硅谷只有 2.534 ms。同一个商家、同一批主机,两条路的脾气完全不一样。
这种差别会直接落到下单上。买之前看到的是某个测评里东京 110.593 ms,自己在广东 ping 出来 231.200 ms。两个 VPS 延迟数字都对,只是源不同。
变量二:VPS 延迟测多少包才准
目标固定在 lax-ca-us-ping.vultr.com,两个源各跑 5 个包数档位。VPS 延迟的这两个源,-c 1 和 -c 4 各 5 轮,-c 5、-c 20、-c 100 各 3 轮,同一时段连续跑完。
| 探测源 | 包数 | 轮数 | 各轮 avg(ms) | 轮次极差(ms) | 该档均值(ms) |
|---|---|---|---|---|---|
| cn-probe-1 | -c 1 | 5 | 255.727 / 254.147 / 253.539 / 253.584 / 255.136 | 2.188 | 254.427 |
| cn-probe-1 | -c 4 | 5 | 254.287 / 254.395 / 254.137 / 254.542 / 257.423 | 3.286 | 254.957 |
| cn-probe-1 | -c 5 | 3 | 255.944 / 255.743 / 255.772 | 0.201 | 255.820 |
| cn-probe-1 | -c 20 | 3 | 254.602 / 254.558 / 255.112 | 0.554 | 254.757 |
| cn-probe-1 | -c 100 | 3 | 254.982 / 254.698 / 255.139 | 0.441 | 254.940 |
| cn-probe-2 | -c 1 | 5 | 155.744 / 158.413 / 155.671 / 155.779 / 155.656 | 2.757 | 156.253 |
| cn-probe-2 | -c 4 | 5 | 156.992 / 156.527 / 157.063 / 156.977 / 156.347 | 0.716 | 156.781 |
| cn-probe-2 | -c 5 | 3 | 156.810 / 156.779 / 156.428 | 0.382 | 156.672 |
| cn-probe-2 | -c 20 | 3 | 156.767 / 157.059 / 156.932 | 0.292 | 156.919 |
| cn-probe-2 | -c 100 | 3 | 156.743 / 156.868 / 156.805 | 0.125 | 156.805 |
广东 -c 5 三轮 255.944 / 255.743 / 255.772,极差 0.201 ms;-c 100 三轮 254.982 / 254.698 / 255.139,极差 0.441 ms。北京反过来,-c 5 极差 0.382 ms,-c 100 降到 0.125 ms。包数不保证离散度下降,它保证的是另一件事:丢包能不能被看见。
跨档看,VPS 延迟的均值更清楚。广东五个档位的均值从 254.427 ms(-c 1)到 255.820 ms(-c 5),跨度 1.393 ms;北京从 156.253 ms(-c 1)到 156.919 ms(-c 20),跨度 0.667 ms。
广东源抖得厉害的是单包和四包这两档:-c 1 极差 2.188 ms、-c 4 极差 3.286 ms。北京源只有单包明显,-c 1 极差 2.757 ms,-c 4 已经降到 0.716 ms。四包一组,一轮里混进一个异常包,均值就跟着走,五轮下来跨度反而比单包更宽。可这点飘动,跟 97.838 ms 的两源差比,不是一个量级。
丢包那一头才是包数真正起作用的地方。广东五个档位全部 0.0%。北京 -c 5 三轮都是 0.0%,-c 20 第 1 轮 5.0%,-c 100 三轮 2.0% / 1.0% / 3.0%。5 个包看不见的那点丢包,100 个包才浮出来。
包数决定的是能不能看见丢包,不是平均值。5 包够判断这条路通不通,100 包才够判断它稳不稳。
还有个坑:-c 1 的 mdev 恒为 0.000。单包没有离散度,这是算法的默认结果,不是线路稳定的证据。拿 mdev=0.000 去证明一条路好,等于拿没测到的当测到了。
站外教程里至少 ping 100 包的说法到处都是,但包数和均值误差的实测关系,目前没见到有人列出来。这张表就是那个关系:链路稳定时,5 包和 100 包的均值差不到一毫秒。
变量三:VPS 延迟里 ICMP 与 TCP 测的不是一件事
测 VPS 延迟,ping 打的是 ICMP,curl 打的是 TCP 三次握手再叠一层 TLS。两条路上任何一段对 ICMP 限速或者降优先级,两个数字就会分开。
| 站点 | 探测源 | ping 丢包 | ping avg(ms) | HTTP 码 | TCP 建连(s) | TLS 完成(s) | 解析到的 IP |
|---|---|---|---|---|---|---|---|
| Vultr 官网 | cn-probe-1 | 0.0% | 229.000 | 301 | 0.435 | 0.681 | 108.61.13.174 |
| Vultr 官网 | cn-probe-2 | 40.0% | 231.243 | 301 | 0.741 | 1.323 | 108.61.13.174 |
| RackNerd 官网 | cn-probe-1 | 0.0% | 207.334 | 200 | 0.313 | 0.581 | 172.66.154.167 |
| RackNerd 官网 | cn-probe-2 | 0.0% | 203.114 | 200 | 1.769 | 2.280 | 104.20.36.161 |
Vultr 官网在北京源丢包 40.0%,平均值 231.243 ms;同一刻 curl 拿到 301,TCP 建连 0.741 s,TLS 1.323 s。网站是开的。这就是「ping 不通但网页能打开」最常见的样子:不是被墙,是该目标在当前源不回 ICMP。
ICMP 在很多网络设备上属于最低优先级的流量,路由器自己 CPU 忙的时候,先丢的就是它。TCP 是真实业务流量,没人敢随便丢。所以一条路 ICMP 丢 40.0%、TCP 照常握手,是设备策略问题,不是链路坏了。
分歧更大的是 RackNerd。广东 ping 207.334 ms、丢包 0.0%,建连 0.313 s;北京 ping 203.114 ms、丢包 0.0%,建连 1.769 s。ping 只差 4.220 ms,握手差 1.456 s,5.7 倍。
原因藏在最后一列。广东解析到 172.66.154.167,北京解析到 104.20.36.161,两个都是 Cloudflare 的边缘地址,不是 RackNerd 机房里的机器。ICMP 打的是哪个边缘节点都会回的那条路,TCP 打的是你实际被调度到的那台边缘机。两个源落到不同节点,ping 看着差不多,握手就能差出五倍。
这也是商家首页域名不能当机房延迟用的原因。Vultr 那个 108.61.13.174 是 Vultr 自己的站点边缘,RackNerd 那两个是 Cloudflare 的边缘,都不是机房里的测试主机。它们只能说明 ICMP 和 TCP 会分歧,不能说明机房有多快。
自己补一条 TCP,一条命令就够:
curl -o /dev/null -s -w 'tcp=%{time_connect} tls=%{time_appconnect} total=%{time_total}\n' https://www.example.com/
time_connect 是握手完成的时间,单位秒。它和 VPS 延迟的毫秒数不是同一个量,别直接相减。TLS 那一列同理,1.323 s 和 0.681 s 的差来自握手次数和证书链长度,跟 ICMP 无关。
变量四:末跳 RTT 不能当 VPS 延迟
tracepath 输出里最后一跳的 RTT,经常被直接抄成「到机房的延迟」。这一轮 tracepath 全部触到 32 跳上限,末跳不是目标主机。
| 机房 | 探测源 | 总跳数 | 末跳 IP | 末跳 RTT(ms) | 端到端 avg(ms) | 差(ms) |
|---|---|---|---|---|---|---|
| 东京 | cn-probe-1 | 32 | 209.222.31.145 | 236.651 | 232.057 | -4.594 |
| 东京 | cn-probe-2 | 32 | 209.222.31.145 | 112.582 | 111.783 | -0.799 |
| 洛杉矶 | cn-probe-1 | 32 | 173.199.80.241 | 175.300 | 254.732 | 79.432 |
| 洛杉矶 | cn-probe-2 | 32 | 173.199.80.241 | 160.989 | 156.636 | -4.353 |
| 法兰克福 | cn-probe-1 | 32 | 108.61.225.49 | 191.046 | 194.716 | 3.670 |
| 法兰克福 | cn-probe-2 | 32 | 108.61.225.49 | 147.679 | 233.320 | 85.641 |
差这一列是端到端减末跳。东京两个源的差都在 4.594 ms 以内,末跳 RTT 和端到端基本重合,说明最后几跳没再绕路。但它同样停在 32 跳上限,末跳 IP 不是 ping 主机的地址,只能当参考。
洛杉矶广东那一行是反例。末跳 175.300 ms,端到端 254.732 ms,差 79.432 ms。末跳比真实延迟小了这么多,因为它根本没到目标。
把前一跳翻出来看更直白。洛杉矶广东这一轮,第 18 跳 173.199.80.241 是 161.865 ms,第 19 跳同一个地址变成 175.300 ms,之后到第 32 跳再没出现新地址。这条路在第 19 跳就走进了不回 ICMP 的区段,末跳是最后一个还肯答话的节点,不是终点。
法兰克福北京同样。末跳 147.679 ms 对端到端 233.320 ms,差 85.641 ms。这两个数字要是被当成机房延迟写进榜单,一个 233.320 ms 的机房会被写成 147.679 ms。
末跳 RTT 不能当延迟用,判断只有一条:末跳的 IP 是不是你要测的那个地址。不是,就不能用。跳数到 32 还没出现目标地址,说明路径没走完,末跳只是路上某个还在回 ICMP 的节点。
VPS 延迟隔 12 天重跑,能差多少
这 7 个机房,2026-10-20 已经用同一台探测机、同一批目标跑过一轮,结果发在 Vultr 机房怎么选 里。2026-11-01 这次是重跑,不是新数据。
| 机房 | 10-20 广东 | 11-01 广东 | 漂移 | 10-20 北京 | 11-01 北京 | 漂移 |
|---|---|---|---|---|---|---|
| 东京 | 234.226 | 231.200 | -3.026 | 110.278 | 110.593 | +0.315 |
| 首尔 | 193.264 | 195.286 | +2.022 | 184.243 | 188.018 | +3.775 |
| 洛杉矶 | 256.822 | 255.652 | -1.170 | 155.730 | 156.370 | +0.640 |
| 硅谷 | 167.164 | 158.476 | -8.688 | 157.394 | 155.942 | -1.452 |
| 法兰克福 | 200.869 | 194.501 | -6.368 | 233.409 | 233.311 | -0.098 |
| 阿姆斯特丹 | 240.430 | 241.248 | +0.818 | 263.776 | 261.193 | -2.583 |
| 悉尼 | 392.888 | 382.624 | -10.264 | 231.549 | 228.095 | -3.454 |
广东侧漂移最大的是悉尼,392.888 到 382.624,10.264 ms,占原值 2.61%;最小阿姆斯特丹 0.818 ms。北京侧最大首尔,184.243 到 188.018,3.775 ms,占原值 2.05%;最小法兰克福 0.098 ms。14 个 VPS 延迟数字的漂移绝对值中位数是 2.583 ms。
名次也动了。广东侧第 2 名换人,10-20 是首尔排在法兰克福前面,两者相差 7.605 ms,11-01 反了过来。北京侧第 2 名同样对调,洛杉矶和硅谷互换,10-20 两者只差 1.664 ms。
整份榜单的顺序也值得对一遍。10-20 广东侧是硅谷、首尔、法兰克福、东京、阿姆斯特丹、洛杉矶、悉尼,11-01 变成硅谷、法兰克福、首尔、东京、阿姆斯特丹、洛杉矶、悉尼,只有第 2、3 名换了位,其余没动。
同一台探测机、同一批目标、隔 12 天,绝对值最大漂 10.264 ms,约 3%。 原始差小于 10 ms 的相邻名次会互换。
所以看到两篇测评同一个机房差几毫秒,先别判线路变好或变差,那可能只是重跑的噪声。名次差在 10 ms 以内的,当作并列看。
不止隔 12 天会漂,同一天隔几个小时也会。上午那轮 -c 100 三轮均值 254.940 ms,下午 12:05 用同一台源、同一个目标、同一条命令再跑 100 包,拿到 265.085 ms,差 10.145 ms,和隔 12 天的最大漂移 10.264 ms 是同一个量级。这一次丢包也上来了,100 个包收 96 个,4.0%。
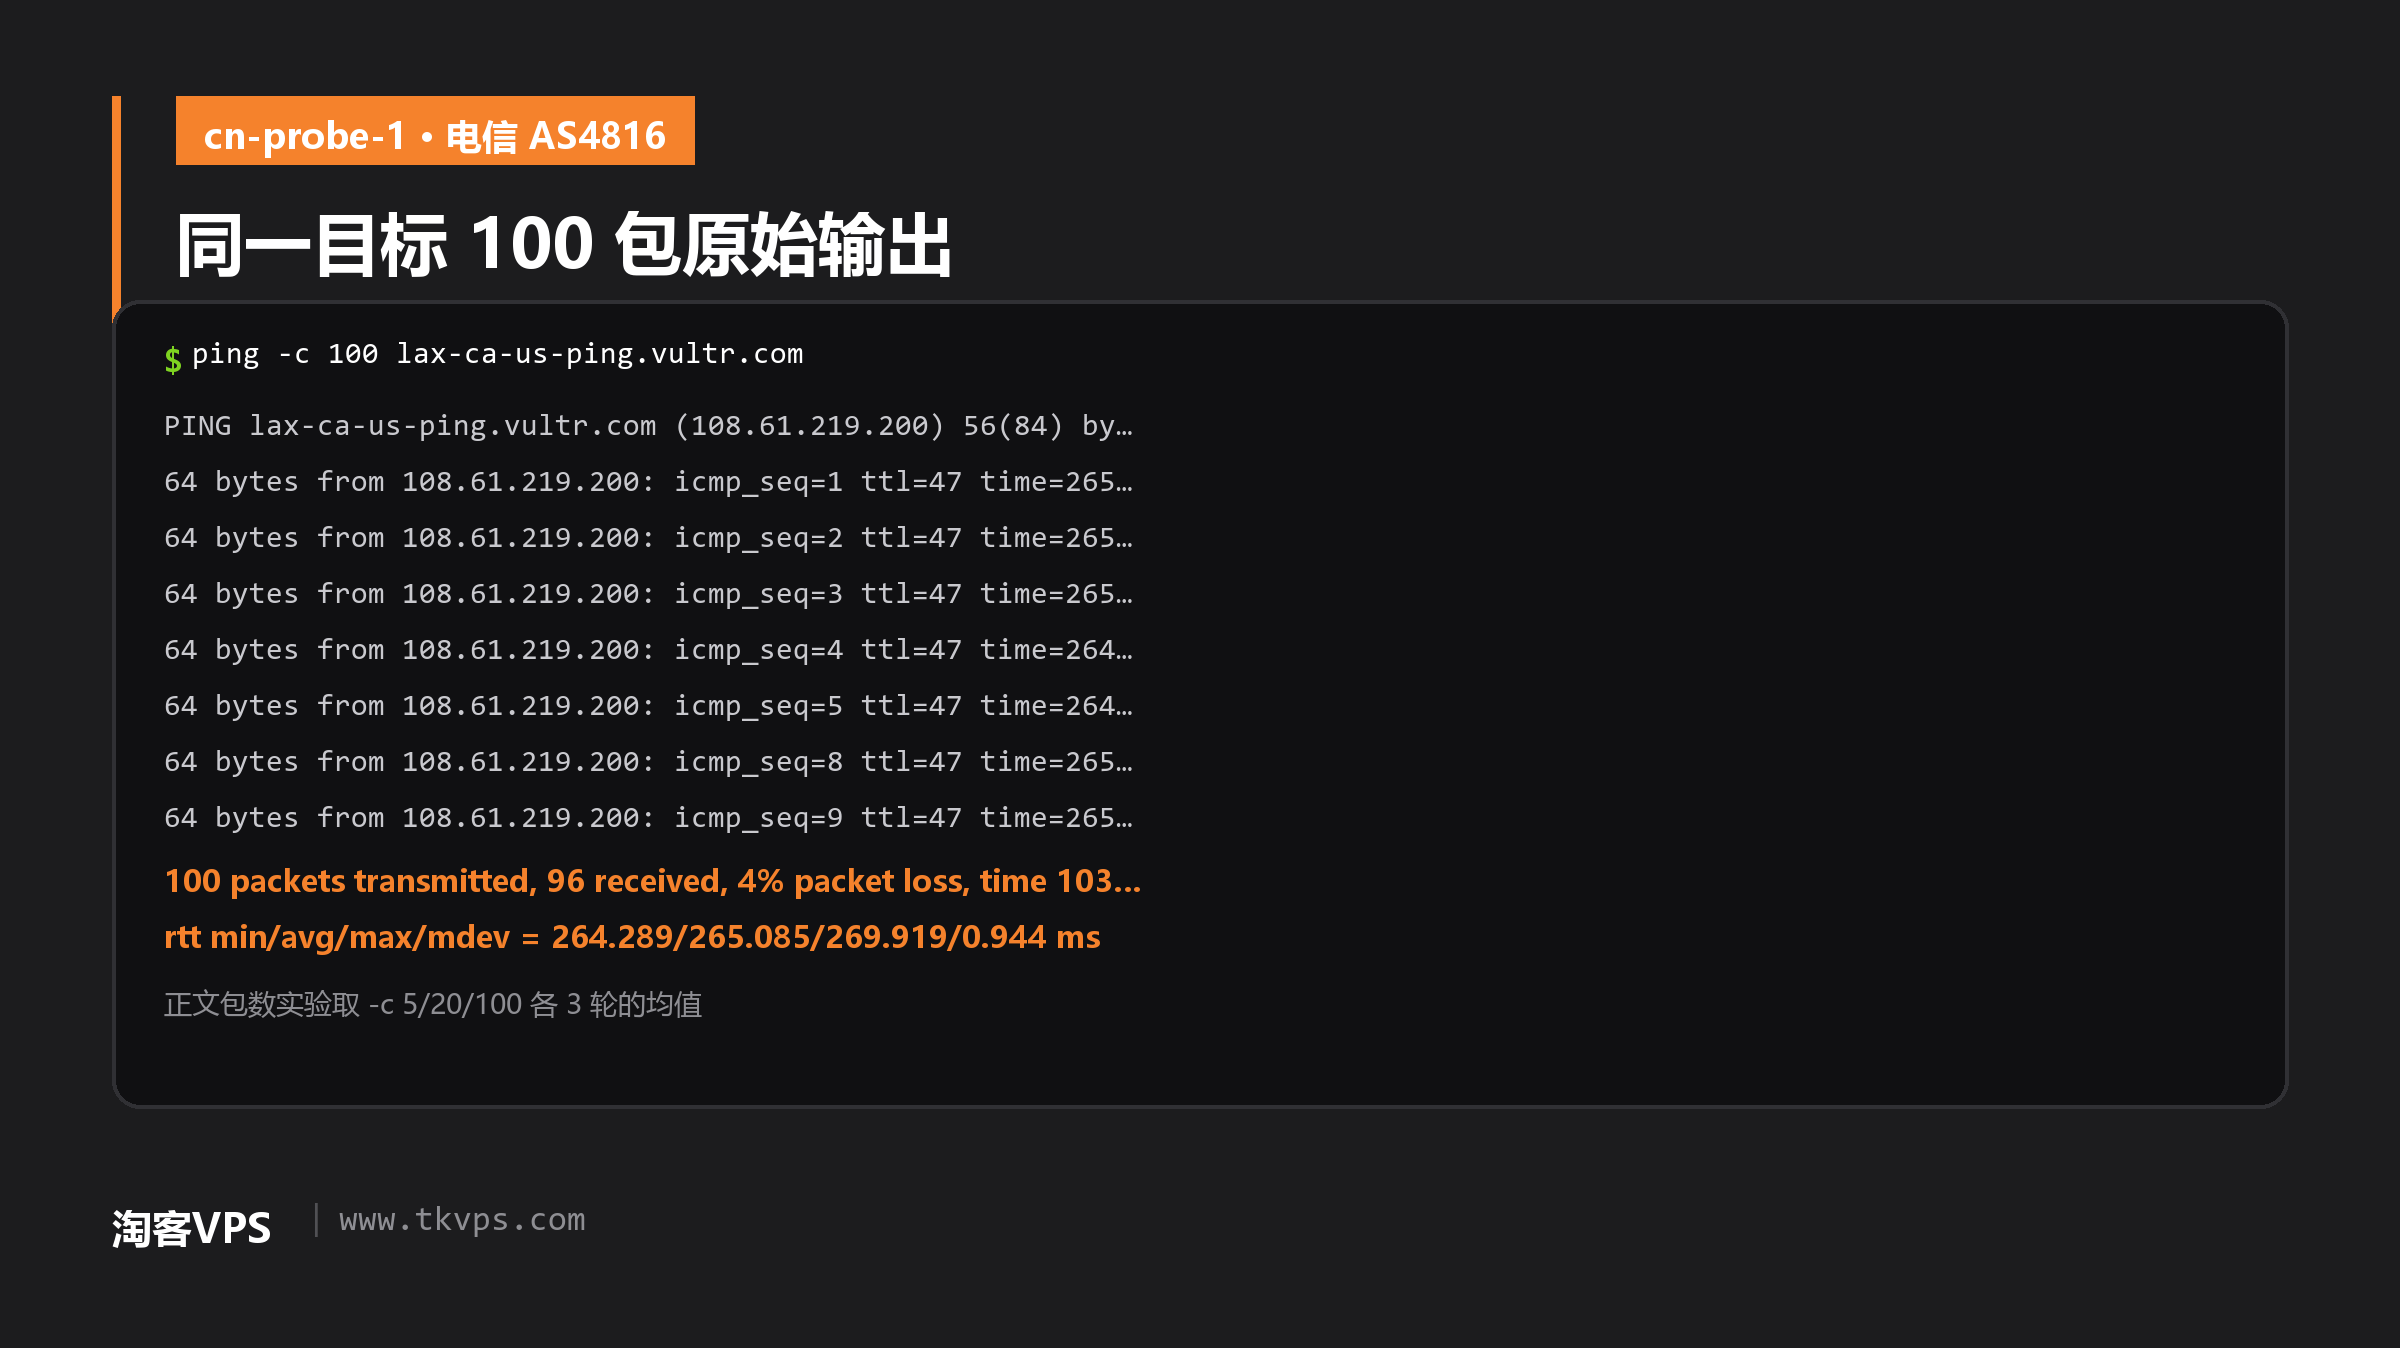
图里那次采样是 265.085 ms,不是表里的 254.940 ms,两批包不是同一时刻的。看到两个数对不上时,先问一句「什么时候测的」,比追问哪个才对更有用。
VPS 延迟怎么测:一套能抄的五步
VPS 延迟怎么测,拆成五步,每步对应前面一个变量。
- 选目标。用商家官方公布的 ping 主机,不要用官网首页域名。首页域名解析到的是站点边缘,和机房不是一回事。
- 包数给到 100。
ping -c 100 -W 2,同时记 min/avg/max/mdev 和丢包。只打 5 包的话,丢包那一列基本是 0,看了等于没看。 - 两个源同时段跑。广东电信一个、北京阿里云一个。单源测出来的 VPS 延迟绝对值,换个省就变。
- 补一条 TCP。握手时间能给你一个 ICMP 给不了的答案。
- 跑一遍路由,只用来认路。
tracepath -n -m 32,看经过哪些段,不取末跳当延迟。
ping -c 100 -W 2 lax-ca-us-ping.vultr.com
curl -o /dev/null -s -w 'tcp=%{time_connect} tls=%{time_appconnect}\n' https://www.example.com/
tracepath -n -m 32 lax-ca-us-ping.vultr.com
路径经过哪几段、回程怎么认,回程线路的辨认方法有单独一篇,这里不展开。
tracepath 输出里星号多不代表断。东京广东这一轮 32 跳里有二十多个星号,路径照样走完了,第 15 跳 209.222.31.145 是 236.651 ms。星号只说明那一跳不回 ICMP,跟通不通没关系。
记录延迟的时候把五个字段都留下:源、时间、包数、avg、丢包。少一个,这个数字三个月后就复现不了。
单源单次的 VPS 延迟只能当参考线,不能当结论。两次测出来差几毫秒,说明不了什么;差出几十毫秒,才值得回去翻路由。VPS 延迟的数字本身不值钱,能复现的口径才值钱。
延迟多少算正常,得带前提
「VPS 延迟多少算正常」这个问题,答案得挂三个前提:从哪儿测、走什么线路、什么时段。三个都不说,给出来的数字只能骗自己。
先把本次两源的分布摆出来:7 个 Vultr 官方 ping 主机、两个源,14 个数字落在 110.593 ms(北京→东京)到 382.624 ms(广东→悉尼)之间。所以「正常」这个词只能相对于源和线路讲,同一台机器,北京源 156.370 ms 算正常,广东源 255.652 ms 也算正常。
同一个洛杉矶目标,广东 255.652 ms、北京 156.370 ms。问哪个算高,先得说清是哪个源。这两个数之间隔着 99.282 ms 的口岸差异。
测评里的数字是从它的源测出来的,你测的是你的源,中间没谁在说谎。东京这一项,两源差 120.607 ms,比好几个机房之间的差距都大。买之前先确认那篇测评的源在哪,比看 VPS 延迟的绝对值有用。
再看东京。北京源 110.593 ms 是 7 个里最低的,但丢包 20.0%。这种数字比 231.200 ms 配 0.0% 丢包更难受。判断顺序应该是:先看丢包,再看 mdev,再看 avg 的绝对值,最后才比名次。
mdev 能看出一部分抖动。广东去悉尼 7.471 ms,去硅谷 0.950 ms,差得很远。前者说明往返时间在上下摆,后者说明它很稳。两个机房的 avg 本来就差得远,mdev 只是把这件事又说了一遍。
时段这一条本次没覆盖。09:10 是上午,晚高峰不在样本里。这条只能自己补:同一个目标,晚八点和早九点各跑一次 -c 100,拿到的 VPS 延迟比任何榜单都直接。
带宽和延迟是两件事,别拿一个替另一个。端口速率换算成月流量那篇算的是另一头。
要按机房横向比,Vultr 各机房的双源实测里有完整对照,那张表解决选哪台,这里解决 VPS 延迟的数字误差。
常见问题
ping 全丢是不是被墙
ping 全丢不等于被墙。100% 丢包只能说明该目标在当前源不回 ICMP。本次 Vultr 官网在北京源丢包 40.0%,同一刻 curl 拿到 301,TCP 建连 0.741 s,网站是开的。先补一条 TCP 再下结论。
ping 多少包才准
均值不用很多包。本次同一目标,广东源 5 包均值 255.820 ms、100 包 254.940 ms,包数从 5 加到 100 均值只动 1.393 ms。包数真正决定的是能不能看见丢包:北京源 5 包三轮全 0.0%,100 包三轮 2.0% / 1.0% / 3.0%。5 包够判断这条路通不通,100 包才够判断它稳不稳。
VPS 延迟怎么测才准
三个条件要写全:从哪儿测、用什么协议测、测了多少包。本次同一台洛杉矶机器,广东电信源 255.652 ms、阿里云北京源 156.370 ms,差 99.282 ms;而同目标换包数只差 1.393 ms。探测源是最大的误差来源,其次是协议,包数最小。
ping 通但端口不通,是延迟问题吗
不是。ICMP 通只说明网络层可达;端口不通是服务没起或者防火墙拦了 TCP,跟延迟无关。用 tcping 或者 curl -v 打那个端口,看是拒绝还是超时,再看延迟。
为什么同一台 VPS 延迟测不准:测评写 156ms,我测 255ms
多半是探测源不同。本次洛杉矶目标,北京源 156.370 ms,广东源 255.652 ms,差 99.282 ms。也可能目标不同:测评打的是官方 ping 主机,你打的是官网域名或者自己的实例。
用手机测的延迟算不算
手机测的延迟只能当参考。手机走移动网络,出口和家宽不是一条,测出来的绝对值通常更高,也没法复现。要比,就用同一台机器、同一条宽带的电脑测。
商家公布的测试 IP,就是我买到的那台吗
不是。那是官方放出来的测试机,代表该机房这个出口的水平,不代表你实例所在的网段。买了之后自己 ping,或者开工单要 looking glass,才看得到你那台。
mtr 中间跳丢包要紧吗
多数不要紧。中间路由器对 ICMP 回包限速或降优先级很常见,只要末跳不丢、端到端不丢,就是正常的。要紧的是从某一跳开始一直丢到最后一跳。
为什么要两个源
VPS 延迟怎么测都绕不开一件事:一个源只能说明一个方向。本次 7 个机房里,北京源更快的有 5 个,广东源更快的有 2 个,悉尼两源差 154.529 ms。只看一个源,另外一半的判断会做反。
VPS 延迟怎么测的结论只对这两个源成立。数据说明:文中所有数字都是中国境内到目标的延迟,不代表机房到其他地区的表现。探测源是两台出口固定的机器,换机器、换运营商,绝对值会变,差值的方向和量级不变。所有 ping 用 2 秒超时,tracepath 全部触到 32 跳上限。末跳那一节里洛杉矶的 175.300 和 254.732 来自 tracepath 那一次采样,与第一节表里的 255.652 不是同一批包,两组不要互相代入。